Nun schauen wir uns drei verschiedene Lernmethoden an mit denen KI trainiert werden kann. In modernen Sprachmodellen wie z.B. ChatGPT werden die Methoden (oder Varianten davon) oft kombiniert angewendet: So kann z.B. nach einem Vortraining nach der Methode des unüberwachten Lernens eine Feinabstimmung nach der Methode des überwachten Lernens folgen. Für den abschliessenden Feinschliff kann noch bestärkendes Lernen durch menschliches Feedback angewendet werden. Die Methoden entwickeln sich stetig weiter, sie basieren jedoch oft immer noch auf diesen drei Grundtrainingsprinzipien. Wir schauen uns zunächst das Unüberwachte Lernen an.
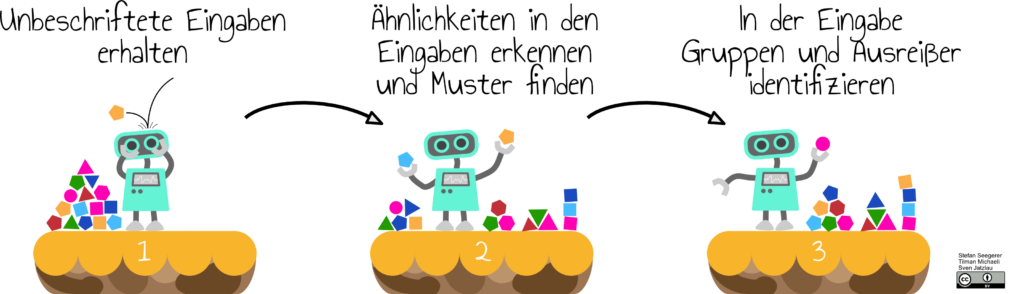
Quelle: https://computingeducation.de/proj-ml-uebersicht/
Beim unüberwachten maschinellen Lernen lernt die KI ohne Unterstützung von Menschen. Wir geben ihr unmarkierte Daten (Unlabeled Data) und lassen sie selbstständig Muster, Strukturen und Ähnlichkeiten in den Daten finden.
- Die KI Bekommt einen Haufen verschiedener Obstbilder ohne Namen. Sie gruppiert die Bilder selbst in Gruppen basierend auf ähnlichen Merkmalen (z.B. Rot & Rund, Gelb & Gebogen, Grün & Klein).
- Das Ziel: Verborgene Strukturen in den Daten aufdecken und die Daten organisieren.
K-Means Algorithmus
Um das Prinzip des unüberwachten maschinellen Lernens zu veranschaulichen, schauen wir uns eine konkrete Variante an: den K-Means-Algorithmus. Er gehört zu den Verfahren, mit denen Maschinen von allein Ähnlichkeiten zwischen verschiedenen Objekten finden.
Stell dir K-Means als Sortierroboter vor, der einen Haufen unsortierter Dinge (deine Daten) in K Behälter aufteilen soll (z.B. 3 oder 4). Das Ziel: Alle Dinge in einem Behälter sollen sich möglichst ähnlich sein.
Eine zentrale Rolle spielen dabei die Zentroide. Ein Zentroid ist der Mittelpunkt einer Gruppe. Es ist der Punkt, der genau in der Mitte aller Dinge liegt, die zu dieser Gruppe gehören. Du kannst ihn dir als «Stellvertreter» der Gruppe vorstellen: einen einzelnen Punkt, der die ganze Gruppe repräsentiert. Rechnerisch ist er der Durchschnitt aller Punkte einer Gruppe, ähnlich wie der Durchschnitt mehrerer Zahlen. Am Anfang kennt der Roboter diese Mittelpunkte noch nicht; er beginnt deshalb mit einer groben Schätzung und verbessert sie Schritt für Schritt.
So funktioniert K-Means in drei Schritten:
- Zufällig starten: Der Roboter setzt K zufällige Punkte in die Daten. Das sind die ersten, noch geratenen Zentroide. Sie dienen als vorläufige Mittelpunkte der zukünftigen Gruppen.
- Gruppen bilden (zuordnen): Jeder Datenpunkt prüft, welchem Zentroid er am nächsten liegt, und schliesst sich diesem an. So entstehen die ersten Gruppen.
- Verbessern (Zentroide verschieben): Für jede Gruppe berechnet der Roboter nun den echten Mittelpunkt, den Durchschnitt aller Punkte, die gerade zu ihr gehören. Dann verschiebt er den Zentroid genau dorthin.
Danach wiederholen sich Schritt 2 und 3: Weil die Zentroide sich bewegt haben, ordnen sich einige Datenpunkte einer neuen, näher gelegenen Gruppe zu – woraufhin sich die Mittelpunkte erneut verschieben. Das geht so lange weiter, bis sich die Zentroide kaum noch bewegen. Dann ist die Sortierung abgeschlossen und du hast deine Gruppen gefunden. In der nächsten Aktivität kannst du interaktiv mit dem Algorithmus experimentieren.
Praxisaufgabe: Unüberwachtes Lernen visualisieren
- Gehe auf https://clustering-visualizer.web.app/kmeans
- Zeichne im Webinterface zufällig verschiedene Punkte auf die Karte. Die Punkte sind eine vereinfachte (vektorisierte) 2D-Darstellung unsere verschiedenen Objekte mit ihren Attributen (z.B. Farbe, Grösse, etc.).
- Je nachdem wie viele Gruppen du identifizieren möchtest, wähle deinen Wert für K.
- Klicke auf «Run K-Means».
- Beobachte, wie der Algorithmus die Datenpunkte ohne Vorwissen in K Gruppen (Cluster) einteilt. Die Punkte werden farbig.
- Lies nochmal die Beschreibung vom K-Means Algorithmus durch und verwende die Visualisierung, um die Schritte zu verfolgen.
- Wiederhole das Experiment mit verschiedenen Punktanordnungen, die für den Menschen recht einfach auseinanderzuhalten sind: Drei verschiedene Punktgruppen, ein äusserer Kreis und ein innerer Kreis, “verschlungene Muster” wie z.B. das Yin und Yang-Zeichen
- Versuche dann die untenstehenden Reflexionsfragen zu beantworten.
Zum Überlegen
Woran erkennst du, welche Punkte zu einer Gruppe gehören?
Sie haben die gleiche Farbe und liegen meist räumlich nahe beieinander.
Verändert sich die Gruppeneinteilung, wenn du den Wert von K änderst?
Ja. Mehr Cluster teilen die Daten feiner auf, weniger Cluster fassen mehr Punkte zusammen.
Warum gehört K-Means zum unüberwachten Lernen?
Weil keine richtigen Antworten oder Labels vorgegeben sind. Der Algorithmus findet die Gruppen selbst. Wir geben nur die Anzahl von erwarteten Clustern vor – es gibt aber auch andere Varianten des unüberwachten Lernens, z.B. DBSCAN, welche selbständig die Anzahl der Cluster anhand der Punktedichte ermittelt.
Was passiert, wenn du Kreisformen oder verschlungene Muster zeichnest?
K-Means teilt die Daten oft „falsch“ auf, weil es keine runden oder komplex verschachtelten Strukturen erkennt, obwohl diese für den Menschen offensichtlich sind. K-Means misst nur Entfernungen und bevorzugt die Einteilung in einfache, kompakte Gruppen. Bei komplexeren Strukturen sind Methoden wie DBSCAN im Vorteil, welcher auf Punktedichten basiert. Der Algorithmus ist ebenfalls im Tool verfügbar – wenn du neugierig bist, kannst du ihn direkt ausprobieren!